DeepSeek V3 en 190 lignes de JAX, entraîné sur un MacBook Air
 Olivier Tech
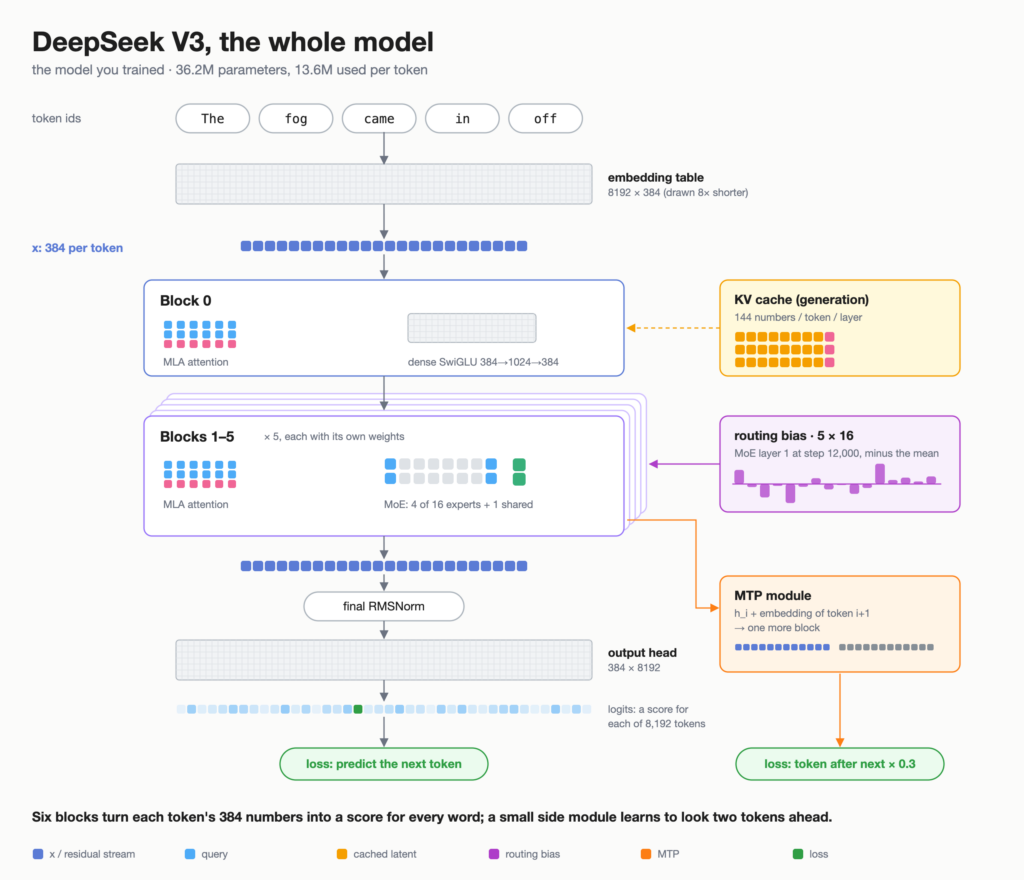
Un développeur a réimplémenté les idées clés de DeepSeek V3 en 190 lignes de JAX pur et a entraîné le modèle de zéro sur un MacBook Air. Le projet vise la pédagogie, pas la performance.
Le dépôt deepseek-v3-jax implémente l’architecture décrite dans le rapport technique de DeepSeek-V3 en 190 lignes de JAX pur. Le modèle a été pré-entraîné de zéro sur un MacBook Air, à partir de romans policiers du domaine public. Le code est sous licence MIT.
D’après News.lavx.hu, ces « 190 lignes » correspondent aux lignes non vides et hors commentaires de deepseek_v3.py, après sa docstring.
Du JAX sans framework
Le code n’utilise ni Flax, ni Equinox, ni PyTorch. Les paramètres sont de simples dictionnaires de tableaux, et le modèle se lit de haut en bas dans un seul fichier.
Le modèle par défaut compte 36,2 millions de paramètres, dont 13,6 millions actifs par token. Face à DeepSeek V3, le projet affiche 36,2 M de paramètres contre 671 Md, 6 couches contre 61 et un contexte de 256 tokens contre 128K.
Les briques de DeepSeek reprises
Avec le cache MLA, l’implémentation stocke 144 valeurs par token et par couche, au lieu de 480. DeepSeekMoE est configuré avec un expert partagé toujours actif et 16 experts routés, dont quatre sont sélectionnés par token.
Le calcul MoE reste dense : chaque expert traite chaque token et les sorties non retenues sont mises à zéro. Il n’y a ni dispatch épars ni parallélisme d’experts.
Selon CCTest, le module de prédiction multi-token prédit le token suivant le suivant, avec un poids de 0,3 dans la perte.
L’entraînement sur un portable
Le corpus compte 207 livres et 21,7 millions de tokens, les œuvres de Dashiell Hammett y étant répétées trois fois. L’entraînement de 12 000 pas a duré environ 2,6 heures sur un MacBook Air M5 de 24 Go, à une vitesse médiane de 10 700 tokens par seconde.
La perte de validation est passée de 5,02 au pas 250 à 3,51 à la fin de l’entraînement rapporté.
Le code tourne aussi sans modification sur le backend ROCm de JAX. Sur une RX 7600 XT (16 Go), l’entraînement complet prend environ 50 minutes à environ 35k tok/s, et atteint une perte de validation de 3,527, contre 3,507 sur Mac.
L’équilibrage des experts en chiffres
Au pas 2000, la charge des experts allait de 5,7 % à 6,9 % avec le biais d’équilibrage, pour un partage idéal de 6,25 %. Sans lui, elle allait de 0,09 % à 18,6 %.
À ce stade, la perte de validation était quasi identique dans les deux cas : 3,921 avec équilibrage contre 3,923 sans.
Limites et mise en route
Les limites annoncées incluent l’absence d’entraînement FP8, de DualPipe, de routage limité par nœud, d’extension de contexte YaRN et de post-entraînement.
Sur Mac, l’exécution exige jax-metal 0.1.1, qui ne fonctionne qu’avec jax==0.4.34. Il ne faut donc pas mettre JAX à jour. Le texte d’entraînement est dans le domaine public aux États-Unis.
Sources
- GitHub (github.com)
- DeepSeek-V3 Core Ideas in 190 Lines of Pure JAX (cctest.ai)
- DeepSeek V3 Architecture Rebuilt in 190 Lines of Pure JAX (news.lavx.hu)
Partager cet article