Rendre son site compatible avec les agents IA : le guide pratique (WordPress)
 Olivier Tech
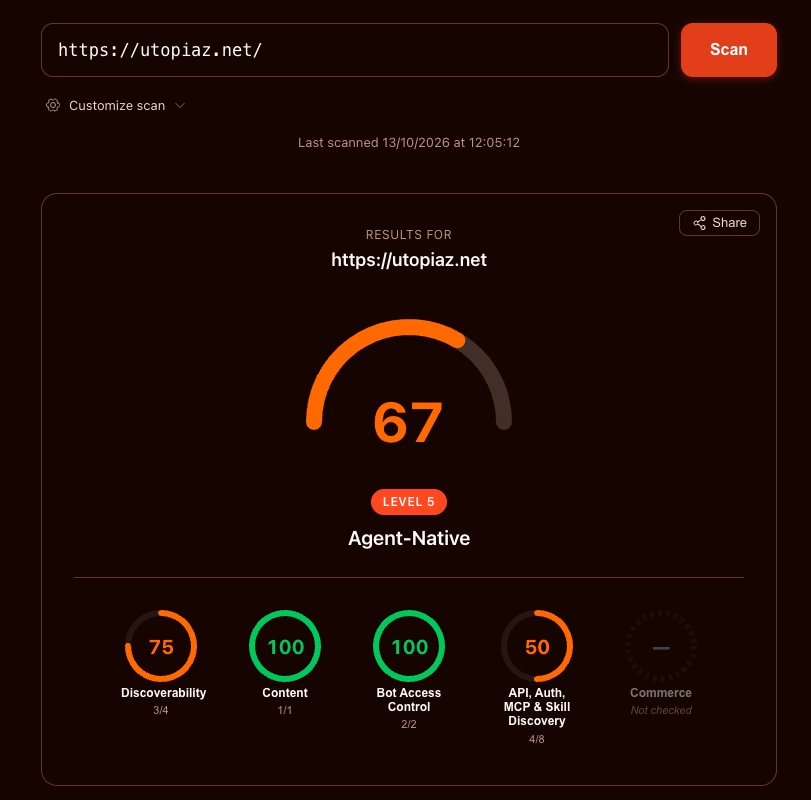
Après la vitesse mobile et l’accessibilité, j’ai passé Utopiaz dans un outil de mesure plus récent : isitagentready.com, qui note un site sur sa capacité à être lu et compris par les agents IA. Les ChatGPT, Claude, Perplexity et autres assistants qui, de plus en plus, vont chercher l’information à ta place.
Verdict : 27 sur 100. Niveau 1, « Basic Web Presence ». Autrement dit, pour une IA, mon blog était à peu près aussi accueillant qu’une porte d’entrée sans sonnette.
Deux jours plus tard, le même outil affiche 67 sur 100, niveau 5, « Agent Native ». Et surtout, en cours de route, j’ai trouvé et corrigé trois failles qui existaient depuis des mois sans que personne ne les remarque. C’est presque la partie la plus intéressante de l’histoire.
Pourquoi s’en soucier
Pendant vingt ans, on a optimisé nos sites pour deux publics : les humains et Googlebot.
Un troisième lecteur est arrivé. Quand tu demandes à un assistant IA « quelle suite bureautique gratuite choisir en 2026 », il ne t’affiche plus dix liens bleus. Il va lire quelques pages, en extraire l’essentiel, et te répondre en citant ses sources.
Le problème, c’est qu’une page web moderne est conçue pour un œil humain. Menus, scripts, publicités, fenêtres de cookies, animations : pour un agent, tout ça est du bruit qu’il doit trier avant d’arriver au texte. Plus le tri est coûteux, moins ta page a de chances d’être lue correctement, et donc citée.
Les vérifications de isitagentready.com reposent presque toutes sur des standards ouverts, des RFC de l’IETF ou des propositions publiques. Rien de propriétaire, rien qui ne dépende d’un fournisseur. C’est ce qui m’a convaincu de m’y intéresser sérieusement.
Étape 1 : servir du markdown aux agents qui le demandent
C’est la vérification la plus utile, et celle que je recommande à tout le monde. Le principe s’appelle la négociation de contenu, et il existe dans HTTP depuis toujours : le client dit ce qu’il préfère recevoir avec l’en-tête Accept, le serveur s’adapte.
Un navigateur demande du HTML. Un agent peut maintenant demander Accept: text/markdown, et recevoir le même article, sans le décor. Voici ce que répondait Utopiaz avant :
$ curl -sI -H 'Accept: text/markdown' https://utopiaz.net/
HTTP/2 200
content-type: text/html; charset=UTF-8
vary: Accept-Encoding
Du HTML, quoi qu’on demande. Et voici la réponse maintenant :
$ curl -sI -H 'Accept: text/markdown' https://utopiaz.net/
HTTP/2 200
content-type: text/markdown; charset=utf-8
vary: Accept
x-markdown-tokens: 1723
content-signal: search=yes, ai-input=yes, ai-train=no
link: <https://utopiaz.net/>; rel="canonical"
Pour un article, l’agent reçoit un petit bloc de métadonnées (titre, description, URL canonique, dates, auteur, catégories), puis le texte converti en markdown. Mon comparatif des suites bureautiques gratuites tient en environ 4 700 tokens, soit une fraction de ce que pèse la page HTML complète.
Côté technique, Utopiaz tourne sous WordPress (en version Bedrock, avec le thème Sage). Tout tient dans un mu-plugin, une extension chargée d’office, qui s’appuie sur la bibliothèque league/html-to-markdown. Quatre règles m’ont semblé importantes.
Le HTML reste la réponse par défaut. Le markdown n’est servi que si text/markdown est demandé explicitement, avec une préférence au moins égale à celle du HTML. Un navigateur, ou un simple curl qui envoie Accept: */*, reçoit toujours la page normale. Aucun visiteur ne voit la différence.
L’en-tête Vary: Accept est obligatoire. Il dit aux caches intermédiaires que la même URL peut produire deux versions selon Accept. Sans lui, un cache pourrait servir du markdown à un humain, ou l’inverse. J’ai vérifié en enchaînant markdown, HTML, markdown, HTML sur la même page : chaque réponse avait le bon format.
Les visiteurs connectés reçoivent toujours le HTML. Le markdown est réservé aux requêtes anonymes, ce qui évite d’avoir à réfléchir à ce qu’un abonné connecté a le droit de voir.
Le markdown ne doit jamais montrer plus que la page. C’est là que j’ai failli me faire avoir.
Le piège des articles réservés
Certains articles d’Utopiaz sont réservés aux abonnés Insider : un visiteur anonyme voit l’introduction, puis une invitation à s’abonner. La méthode classique pour convertir un article WordPress en markdown consiste à reprendre son contenu tel que WordPress le prépare pour l’affichage. Et c’est précisément ce qui ne marche pas chez moi.
Sur Utopiaz, le verrou Insider n’est pas posé sur le contenu lui même, il est posé dans le gabarit de la page, au moment de l’affichage. Le contenu brut, lui, est complet. Si j’avais suivi la méthode classique, le markdown aurait livré gratuitement l’article entier à n’importe quel agent. J’ai donc reproduit dans le plugin exactement la règle du gabarit : introduction publique, puis une phrase qui renvoie vers l’article.
Garde ça en tête si tu as un site avec du contenu payant : chaque nouveau canal de sortie de ton contenu doit réappliquer ton verrou. Ça va servir plus loin.
Étape 2 : des panneaux indicateurs dans les en-têtes
Deuxième vérification : les en-têtes Link de la page d’accueil, définis par la RFC 8288. Ce sont des liens invisibles, envoyés avec la réponse HTTP, qui disent à une machine « voici où trouver ceci ou cela ».
WordPress en envoie déjà un, vers son API. Mais le scanner attend des relations utiles aux agents.
J’en ai ajouté cinq, qui pointent toutes vers des ressources qui existent vraiment :
link: <https://utopiaz.net/.well-known/api-catalog>; rel="api-catalog"
link: <https://utopiaz.net/wp-json/>; rel="service-desc"; type="application/json"
link: <https://developer.wordpress.org/rest-api/>; rel="service-doc"
link: <https://utopiaz.net/llms.txt>; rel="describedby"; type="text/plain"
link: <https://utopiaz.net/>; rel="alternate"; type="text/markdown"
Ce dernier lien est mon préféré : il annonce simplement qu’une version markdown de la page existe. Une règle que je me suis fixée pour toute la suite : ne jamais annoncer une ressource qui n’existe pas. Le lien api-catalog n’a été ajouté qu’une fois le catalogue réellement en ligne.
Étape 3 : dire ce que les IA ont le droit de faire
Les Content Signals sont une proposition récente, en cours de discussion à l’IETF, pour déclarer dans le fichier robots.txt ce que tu autorises les IA à faire de ton contenu. Trois signaux :
search : apparaître dans les résultats de recherche.ai-input : être lu en direct par une IA pour répondre à quelqu’un, et donc être cité.ai-train : servir à entraîner des modèles.
Mon choix pour Utopiaz :
User-agent: *
Content-Signal: search=yes, ai-input=yes, ai-train=no
Oui à la recherche, oui aux assistants qui lisent et citent mes articles, non à l’entraînement. La nuance entre les deux derniers me paraît essentielle. Qu’une IA lise mon comparatif pour répondre à ta question et renvoie vers moi, c’est le web qui fonctionne. Qu’elle l’absorbe pour toujours dans ses poids sans jamais me citer, c’est autre chose.
Soyons honnêtes : c’est une déclaration de préférence, pas un verrou. Les acteurs sérieux la respectent, les autres l’ignorent. Mais elle a le mérite d’exister, d’être lisible par une machine, et de poser clairement les règles. La même valeur est envoyée dans l’en-tête des réponses markdown : une seule ligne à changer dans le code si je change d’avis.
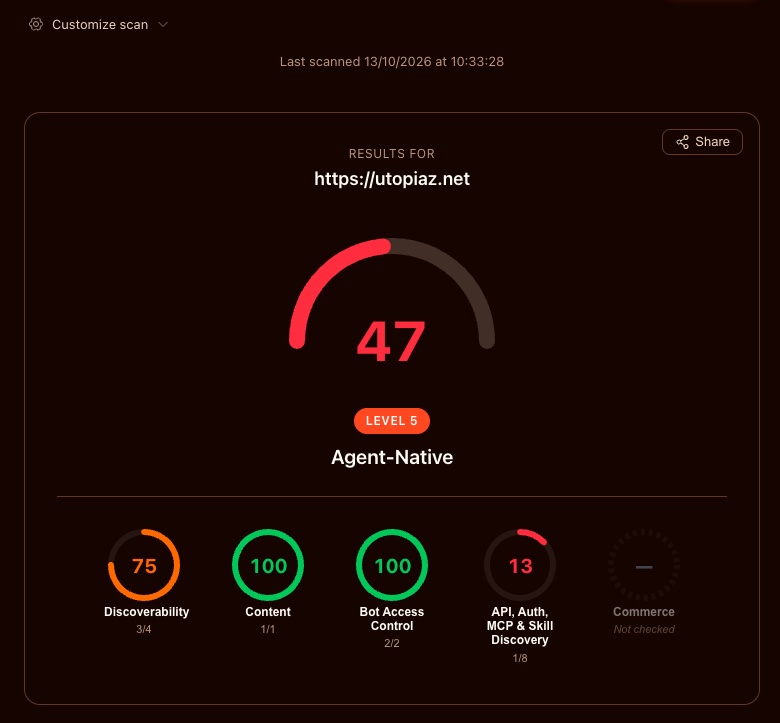
Avec ces trois premières étapes, le score passe de 27 à 47.
Étape 4 : des catalogues pour les machines
La dernière catégorie du scan, « API, Auth, MCP & Skill Discovery », est la plus exigeante.
Elle vérifie que ton site publie des fichiers de description dans le dossier /.well-known/, l’endroit standard où les machines vont chercher ce genre d’information. J’en ai publié trois, et c’est là que la règle « rien de nouveau, rien d’inventé » a pris tout son sens.
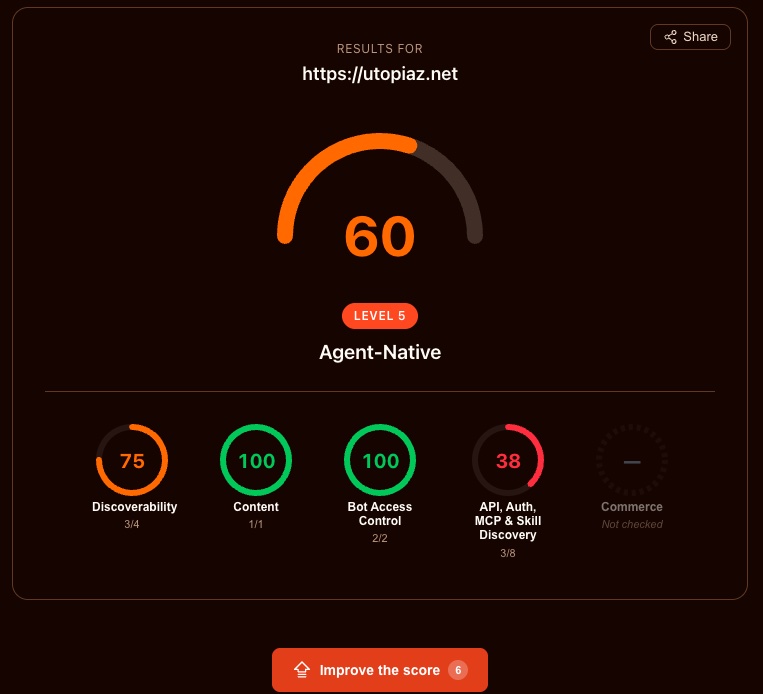
Le catalogue d’API (/.well-known/api-catalog, RFC 9727) est un petit fichier JSON qui liste les API publiques du site et leur documentation. Il ne mentionne qu’une seule chose : l’API de lecture de WordPress, qui était de toute façon déjà publique. Les routes internes du site n’y figurent volontairement pas. Score : 53.
Le manifeste ARD (/.well-known/ai-catalog.json, pour Agentic Resource Discovery) fait le même travail en plus large : il présente le site et ses ressources, chacune avec quelques exemples de questions auxquelles elle sait répondre, comme « derniers articles publiés sur Utopiaz ». Quatre entrées : le catalogue d’API, l’API de lecture, le fichier llms.txt et le flux RSS. Score : 60.
Les Agent Skills (/.well-known/agent-skills/index.json) sont des modes d’emploi rédigés pour les agents. J’en ai écrit deux. Le premier explique comment chercher et lire les articles d’Utopiaz, en précisant que les articles Insider ne livrent que leur introduction et qu’il faut toujours citer l’URL. Le second explique comment lire l’agenda des concerts, avec un détail qu’un agent ne pouvait pas deviner : dans ce flux, la date de publication est en réalité la date du concert. Score : 67.
Les trois failles trouvées en chemin
C’est le passage que je n’avais pas prévu d’écrire. En regardant de près ce que mon site exposait aux machines, j’ai découvert que certaines portes étaient ouvertes depuis longtemps.
Faille 1 : la liste des comptes en accès libre
Par défaut, WordPress publie la liste de ses auteurs à l’adresse /wp-json/wp/v2/users. Chaque fiche contient un « slug », l’identifiant qui sert dans l’adresse de la page auteur. Et par défaut, ce slug est identique à l’identifiant de connexion. N’importe qui pouvait donc connaître la moitié des identifiants des comptes les plus puissants du site, administrateur compris.
Deux corrections. La liste n’est plus accessible qu’aux comptes connectés qui rédigent (l’éditeur WordPress en a besoin). Et les slugs des auteurs ont été renommés pour ne plus rien révéler. Les identifiants de connexion ne changent pas, seules les adresses publiques changent.
Faille 2 : les pages auteur qui répondent « oui » ou « non »
Les pages auteur d’Utopiaz étaient déjà désactivées et redirigeaient vers l’accueil. Mais uniquement pour les comptes existants : un identifiant inconnu donnait une erreur 404. Il suffisait donc de tester des noms un par un pour savoir lesquels existaient, abonnés compris. Ça s’appelle un oracle, et c’est un grand classique. Désormais, toute adresse d’auteur renvoie exactement la même réponse, que le compte existe ou non.
Faille 3 : les articles payants lisibles gratuitement
La plus sérieuse. En rédigeant le mode d’emploi des articles pour les agents, j’ai voulu vérifier ce que l’API de WordPress renvoyait pour un article Insider. Réponse : le texte intégral. Plus de 1 500 mots, quand la page n’en montre que l’introduction.
La cause est exactement celle du piège décrit plus haut : le verrou était posé dans le gabarit de la page, et l’API ne passe jamais par ce gabarit. Le contenu payant était donc accessible à quiconque connaissait l’adresse de l’API, c’est à dire n’importe quel développeur WordPress. L’API applique maintenant la même règle que la page. Le flux RSS, lui, ne fuyait pas : il ne contenait déjà qu’un court résumé.
Si tu as un site WordPress avec du contenu réservé, va vérifier ça chez toi. Ouvre /wp-json/wp/v2/posts/ suivi du numéro d’un article payant, dans une fenêtre de navigation privée. Si tu vois l’article complet, tu as le même problème.
Ce que j’ai volontairement refusé
Le score aurait pu monter plus haut. J’ai choisi de m’arrêter, et ces refus comptent autant que le reste.
Annoncer un serveur MCP. Le protocole MCP permet à une IA de piloter un service : créer des contenus, gérer des comptes. Le scan récompense les sites qui en annoncent un. Sauf que sur un blog, un tel serveur sert à l’administration. L’annoncer publiquement, c’est mettre une pancarte « porte de service ici » à destination de tous les robots du web. Non merci.
Déclarer tout le site comme protégé. Un autre test attend un fichier qui décrit comment s’authentifier auprès du site (RFC 9728). Pour le satisfaire, il aurait fallu déclarer que tout Utopiaz est protégé par authentification. C’est faux : le blog est public. Je préfère un score honnête à une déclaration inexacte.
Le DNS pour les agents. La dernière vérification attend un type d’enregistrement DNS récent, appelé SVCB. Mon hébergeur DNS ne le propose tout simplement pas. Changer d’hébergeur pour un brouillon de norme qu’aucun agent n’utilise encore ? Aucun intérêt. J’ai seulement ajouté un enregistrement texte qui pointe vers le manifeste ARD, ce que mon hébergeur permet.
Et pour lever une inquiétude qu’on m’a remontée : non, publier ces fichiers ne fait pas de ton blog « un agent IA » au sens du règlement européen sur l’IA. Un catalogue d’API, c’est un annuaire, pas un système d’IA. Ton site reste un site, il devient juste plus facile à lire pour les machines.
Le point de vue Utopiaz
Ce qui me frappe, au bout de ces deux jours, c’est à quel point les deux sujets se sont mêlés. Je pensais faire de l’optimisation pour les IA. J’ai surtout fait un audit de ce que mon site expose. Rendre un site lisible par les machines oblige à regarder ce qu’il dit vraiment aux machines, et ce regard là, on ne le pose presque jamais.
Le score lui même est à prendre pour ce qu’il est : un outil récent, qui mélange des standards solides et des brouillons, et dont l’étiquette « Agent Native » relève davantage du marketing que d’une certification. Mais les briques les plus utiles sont simples, ouvertes et sans risque. Le markdown à la demande et les Content Signals, en particulier, devraient devenir aussi banals que le sitemap.
Viser 100 n’a pas de sens pour un blog. Viser un site honnête, qui ne promet que ce qu’il offre et ne laisse rien fuir, en a beaucoup.
Et toi, tu as déjà passé ton site dans isitagentready.com ? Partage ton score en commentaire, je suis curieux de voir où en sont les autres blogs indépendants.
Pour ne rien manquer des prochains dossiers tech, la newsletter Utopiaz arrive chaque dimanche matin. N’hésite pas à d’abonner 🙂
Partager cet article